Prim: 정점을 점점 확장해 나가는 방식 (힙을 써서 구현 - 정점번호, 가중치 저장) --> 최소값을 우선 순위 큐를 이용하면 최소 값을 logE만에 찾을 수 있다. 이 경우 시간복잡도는 O(ElogE)가 된다. 모든 간선이 힙에 한번 씩 들어갔다가 나오기 때문
그래프에서 아무 정점이나 선택한다.
선택한 정점과 선택하지 않은 정점을 연결하는 간선 중에 최소값을 고른다. 이 간선을 (u, v)라고 한다.
선택한 간선을 최소 스패닝 트리에 추가하고, 선택하지 않았던 정점 v를 선택한다.
2번으로 돌아간다
Kruskal: 간선을 점점 확장해 나가는 방법
가중치가 작은 edge부터 살펴본다 --> 간선의 길이 순으로 먼저 정렬해야 한다. O(ElogE)
edge e가 (u, v, c)일 때, u와 v가 서로 다른 집합이면 e를 최소 스패닝 트리에 추가한다. O(E) - union/find 연산
Prim 알고리즘 풀이
import java.util.*;

public class Main {
	public static void main(String[] args) {
		Scanner in = new Scanner(System.in);
		int v = in.nextInt();
		int e = in.nextInt();

		LinkedList<Edge>[] pair = new LinkedList[v + 1];
		HashSet<Integer> vSet = new HashSet<Integer>();
		for (int i = 1; i <= v; i++) {
			pair[i] = new LinkedList<Edge>();
			vSet.add(i);
		}
		for (int i = 0; i < e; i++) {
			int start = in.nextInt();
			int end = in.nextInt();
			long cost = in.nextLong();

			pair[start].add(new Edge(end, cost));
			pair[end].add(new Edge(start, cost));
		}

		int currentNode = 1;
		long ans = 0;
		vSet.remove(1);

		PriorityQueue<Edge> pq = new PriorityQueue<Edge>();
		pq.addAll(pair[currentNode]);

		while (!vSet.isEmpty()) {
			Edge minEdge = pq.poll();

			if (vSet.contains(minEdge.v)) {
				ans += minEdge.cost;
				currentNode = minEdge.v;
				vSet.remove(currentNode);
				pq.addAll(pair[currentNode]);
			}
		}
		System.out.println(ans);
	}
}

class Edge implements Comparable<Edge> {
	int v;
	long cost;

	public Edge(int v, long cost) {
		this.v = v;
		this.cost = cost;
	}

	@Override
	public int compareTo(Edge o) {
		return Long.compare(this.cost, o.cost);
	}
}
Kruskal 알고리즘 풀이
import java.util.*;

public class Main {
	public static void main(String[] args) {
		Scanner in = new Scanner(System.in);
		int v = in.nextInt();
		int e = in.nextInt();

		PriorityQueue<Edge> pq = new PriorityQueue<Edge>();
		int vSet[] = new int[v + 1];

		for (int i = 1; i <= v; i++) {
			vSet[i] = i;
		}

		for (int i = 0; i < e; i++) {
			int start = in.nextInt();
			int end = in.nextInt();
			long cost = in.nextLong();

			pq.add(new Edge(start, end, cost));
		}

		long ans = 0;
		if (!pq.isEmpty()) {
			Edge firstEdge = pq.poll();
			ans += firstEdge.cost;
			union(firstEdge.v1, firstEdge.v2, vSet);
		}

		while (!isFinished(vSet) && !pq.isEmpty()) {
			Edge minEdge = pq.poll();

			int v1Contains = find(minEdge.v1, vSet);
			int v2Contains = find(minEdge.v2, vSet);

			if (v1Contains != v2Contains) {
				ans += minEdge.cost;
				union(minEdge.v1, minEdge.v2, vSet);
			}
		}
		System.out.println(ans);
	}

	public static void union(int x, int y, int[] vSet) {
		int ux = find(x, vSet);
		int uy = find(y, vSet);

		vSet[uy] = ux;
	}

	public static int find(int x, int[] vSet) {
		if (vSet[x] == x) {
			return x;
		}

		vSet[x] = find(vSet[x], vSet);
		return vSet[x];
	}

	public static boolean isFinished(int[] vSet) {
		int now = vSet[1];
		for (int i = 1; i < vSet.length; i++) {
			if (vSet[i] != now) {
				return false;
			}
		}
		return true;
	}
}

class Edge implements Comparable<Edge> {
	int v1, v2;
	long cost;

	public Edge(int v1, int v2, long cost) {
		this.v1 = v1;
		this.v2 = v2;
		this.cost = cost;
	}

	@Override
	public int compareTo(Edge o) {
		return Long.compare(this.cost, o.cost);
	}
}
각 노드에 저장되는 값은 3가지이다 --> 저장되는 칸의 번호, 구간 시작, 구간 끝 (구간시작==구간끝: 리프 노드)
예를 들어 3~5 노드는 구간 3~5에서 최솟값을 저장하고 있다.
배열을 이용해서 구할 수 있다. --> x의 왼쪽 자식은 2x, 오른쪽 자식은 2x+1 이런 식으로,,,
모든 노드는 자식이 무조건 0개 또는 2개이다.
리프 노드가 n개인 full binary tree가 필요한 노드의 개수: 높이 h=lgn일 때 2^(h+1)
import java.util.*;

public class Main {
	public static void main(String[] args) {
		Scanner in = new Scanner(System.in);
		int n = in.nextInt();
		int m = in.nextInt();

		int arr[] = new int[n + 1];
		for (int i = 1; i <= n; i++) {
			arr[i] = in.nextInt();
		}

		int h = (int) Math.ceil(Math.log(n) / Math.log(2));
		int maxTree[] = new int[1 << (h + 1)];
		int minTree[] = new int[1 << (h + 1)];

		initTree(true, arr, maxTree, 1, 1, n);
		initTree(false, arr, minTree, 1, 1, n);

		for (int i = 0; i < m; i++) {
			int start = in.nextInt();
			int end = in.nextInt();

			System.out.print(findSegment(false, minTree, 1, 1, n, start, end) + " ");
			System.out.println(findSegment(true, maxTree, 1, 1, n, start, end));
		}
	}

	public static int initTree(boolean isMaxTree, int[] arr, int[] tree, int index, int start, int end) {
		if (start == end) {
			tree[index] = arr[start];
			return tree[index];
		}

		int mid = (start + end) / 2;

		if (isMaxTree) {
			tree[index] = Math.max(initTree(isMaxTree, arr, tree, index * 2, start, mid),
					initTree(isMaxTree, arr, tree, index * 2 + 1, mid + 1, end));

			return tree[index];
		} else {
			tree[index] = Math.min(initTree(isMaxTree, arr, tree, index * 2, start, mid),
					initTree(isMaxTree, arr, tree, index * 2 + 1, mid + 1, end));

			return tree[index];
		}
	}

	public static int findSegment(boolean isFindMax, int[] tree, int index, int start, int end, int left, int right) {

		if (left > end || right < start) {
			// 범위와 관계 없어서 볼 필요가 없을 때
			return -1;
		}

		if (left <= start && right >= end) {
			// 범위에 구간이 포함되는 경우, left - start - end - right
			return tree[index];
		}

		// 범위에 구간이 일부 포함되는 경우
		// left - start - right - end 또는
		// start - left - right - end
		int mid = (start + end) / 2;
		if (isFindMax) {
			return Math.max(findSegment(isFindMax, tree, index * 2, start, mid, left, right),
					findSegment(isFindMax, tree, index * 2 + 1, mid + 1, end, left, right));
		} else {
			int segmentLeft = findSegment(isFindMax, tree, index * 2, start, mid, left, right);
			int segmentRight = findSegment(isFindMax, tree, index * 2 + 1, mid + 1, end, left, right);

			if (segmentLeft == -1) {
				return segmentRight;
			} else if (segmentRight == -1) {
				return segmentLeft;
			} else {
				return Math.min(segmentLeft, segmentRight);
			}
		}
	}
}
누적합을 구해두고 for문으로 (a[i]+...+a[j])를 구하면 O(N^2)만에 풀 수 있지만,
n<=10^6이고 시간 제한이 1초이므로 다른 방법을 생각해야 한다.
(a[i]+...+a[j])%m == 0
<=> (s[j]-s[i-1])%m == 0
<=> s[j]%m == s[i-1]%m 와 같으므로
mod[k]: s[i]%m == k인 i의 갯수를 저장한다면
mode[k]C2를 모두 더하면 된다.
주의할 점은 s[i]%m==0인 i는 그 자체로 답이 되므로 바로 ans++해준다.
import java.util.*;

public class Main {
	public static void main(String[] args) {
		Scanner in=new Scanner(System.in);
		int n=in.nextInt();
		int m=in.nextInt();

		int sum=0;
		long mod[]=new long[m];
		long ans=0;

		for(int i=0;i<n;i++) {
			int input=in.nextInt();
			sum+=input;
			sum%=m;
			mod[sum]++;

			if(sum==0) {
				ans++;
			}
		}

		for(int i=0;i<m;i++) {
			long value = mod[i];
			long combination = value*(value-1)/Long.valueOf(2);
			ans+=combination;
		}
		System.out.println(ans);
	}
}
import java.util.*;
import java.io.*;

public class Main {
	public static void main(String[] args) throws IOException {
		BufferedReader br = new BufferedReader(new InputStreamReader(System.in));
        BufferedWriter bw = new BufferedWriter(new OutputStreamWriter(System.out));
        StringTokenizer st;

        st = new StringTokenizer(br.readLine());
		int n=Integer.parseInt(st.nextToken());
		int l=Integer.parseInt(st.nextToken());
		int arr[]=new int[n];

		st = new StringTokenizer(br.readLine());
		for(int i=0;i<n;i++) {
			arr[i]=Integer.parseInt(st.nextToken());
		}

		Deque<Node> deque=new ArrayDeque<Node>();
		for(int i=0;i<n;i++) {
			int currentValue=arr[i];

			if(!deque.isEmpty() && deque.getFirst().index <=i-l) {
				// 최솟값이 될 수 없는 경우: 인덱스 차이가 넘 크다
				deque.pollFirst();
			}

			while(!deque.isEmpty() && deque.getLast().value>currentValue) {
				// 최솟값이 될 수 없는 경우: 값이 넘 크다
				deque.pollLast();
			}

			deque.offer(new Node(currentValue, i));
			arr[i] = deque.getFirst().value;
		}

		for(int i=0;i<n;i++) {
			bw.write(arr[i] + " ");
		}

		bw.flush();
		bw.close();
	}
}
class Node{
	int value;
	int index;

	public Node(int value, int index) {
		this.value=value;
		this.index=index;
	}
}
여기서는 괜찮았지만, 원래 viewpager2의 layout_width와 layout_height는 match_parent로 해 주어야 에러가 안난다고 한다. 그래서 만약에 크기를 지정해서 사용하고 싶다면 viewpager2를 다른 뷰 그룹으로 감싸주고 상위 뷰의 크기를 변경하도록 해야한다.
viewPager2는 RecylerView.Adapter또는FragmentStateAdapter로 설정할 수 있다.
Adapter란 하나의 객체로서, 뷰와 그 뷰에 올릴 데이터를 연결한다.
즉, 데이터의 원본을 받아 관리하고, 뷰가 출력할 수 있는 형태로 데이터를 제공한다.
암튼 두 어댑터의 차이점을 알아보니 아래와 같음
RecyclerView.Adapter
viewPager가 PagerAdapter로 뷰를 통해 페이징 하는 경우
pagerAdapter: if you only want to have code that isn't going to be reused
FragmentStateAdapter
viewPager가 FragmentPagerAdapter로 정해진 소수의 fragment를 통해 페이징 하는 경우
viewPager가 FragmentStatePagerAdapter로 많은 수/다이나믹한 프래그먼트를 통해 페이징 하는 경우
fragment--Adapter: you can use fragments inside this. if you want to have fragments that are going to be used in other parts of your code ~~
그래서 FragmentStateAdapter으로 ScreenSlidePagerAdapter을 구현하도록 했다.
package com.app.priaryapp.adapter;

import androidx.annotation.NonNull;
import androidx.fragment.app.Fragment;
import androidx.fragment.app.FragmentActivity;
import androidx.viewpager2.adapter.FragmentStateAdapter;

import com.app.priaryapp.view.tutorial.TutorialFragment;

import java.util.ArrayList;
import java.util.List;

public class ScreenSlidePagerAdapter extends FragmentStateAdapter {

    private List<Integer> layouts = new ArrayList<>();

    public ScreenSlidePagerAdapter(FragmentActivity fragmentActivity, List<Integer> layouts) {
        super(fragmentActivity);
        this.layouts = layouts;
    }

    @NonNull
    @Override
    public Fragment createFragment(int position) {
        return TutorialFragment.newInstance(layouts.get(position));
    }


    @Override
    public int getItemCount() {
        return layouts.size();
    }
}
ScreenSlidePagerAdapter는 알아서 TutorialFragment를 객체를 만든다. 이 때 주의할 점은 button객체와 onclick을 붙일 때 fragment 안에 있는 것이므로 fragment에서 해야하지 뒤에 나오는 TutorialActivity에서 하면 Null Pointer Error가 나와서 안됨
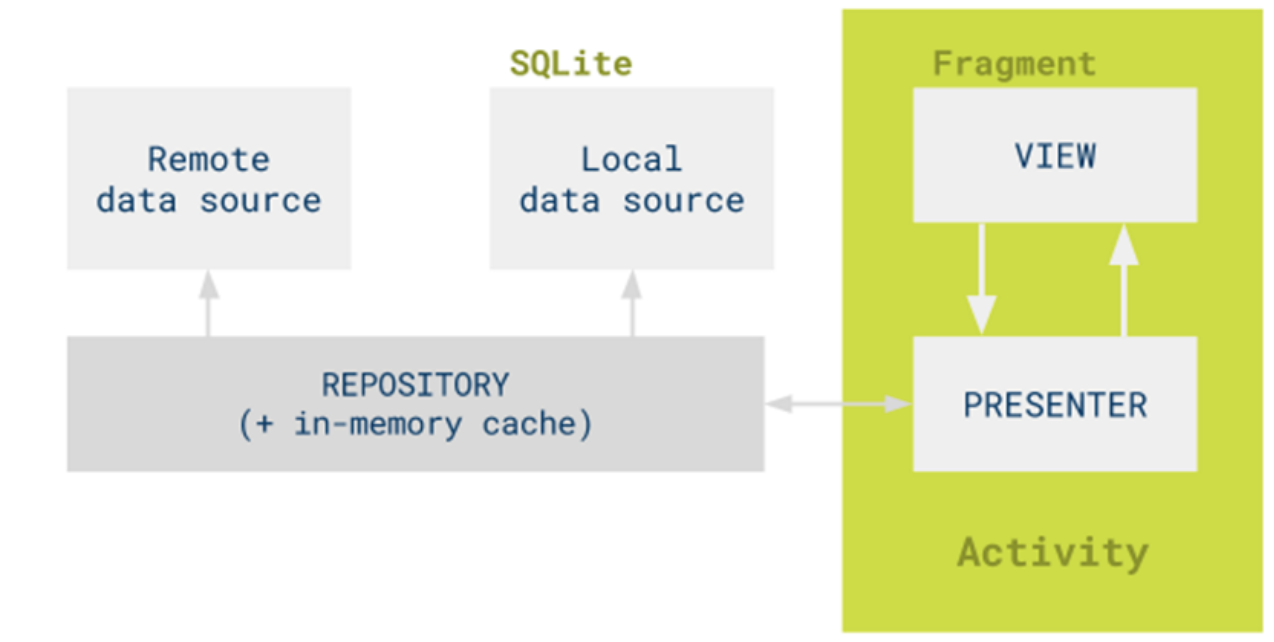
참고로 안드로이드 프로젝트는 MVP 패턴(Model-View-Presenter)으로 패키지를 나누는게 좋다고 한다.
MVP 패턴
View: Activity/Fragment가 해당되며 실제 뷰에 대한 직접적인 접근을 담당한다. 뷰에서 발생하는 이벤트는 직접 핸들링 할 수 있으나 Presenter에 위임하도록 한다. 위임하는 방법은 액티비티가 뷰 인터페이스를 구현해서 Presenter에서 코드를 만들 인터페이스를 갖도록 하면 된다고 한다. 이렇게 하면 특정 뷰와 결합되지 않고 가상 뷰를 구현하여 간단한 유닛 테스트를 할 수 있다.
Presenter: MVC 모델에서 컨트롤러 역할과 비슷한데, 뷰에 연결되는 것이 아니라 인터페이스로 연결된다. 뷰와 모델 사이의 자료 전달 역할을 한다.
Model: 앱 데이터를 말하는데, 데이터 그 자체 외에도 데이터를 관리, 수집, 수정 등을 하는 부분이다.
import java.util.*;

public class Main {
	public static void main(String[] args) {
		Scanner in = new Scanner(System.in);
		int n = in.nextInt();

		int[] depth = new int[n + 1];
		int[] parentNode = new int[n + 1];
		int[] distances = new int[n + 1];
		boolean[] isVisited = new boolean[n + 1];
		LinkedList<Node> pair[] = new LinkedList[n + 1];
		for (int i = 1; i <= n; i++) {
			pair[i] = new LinkedList<Node>();
		}

		for (int i = 1; i < n; i++) {
			int node1 = in.nextInt();
			int node2 = in.nextInt();
			int distance = in.nextInt();
			pair[node1].add(new Node(node2, distance));
			pair[node2].add(new Node(node1, distance));
		}

		depth = calculateNodeDepth(pair, parentNode, distances, n);

		int test = in.nextInt();

		for (int t = 0; t < test; t++) {

			int node1 = in.nextInt();
			int node2 = in.nextInt();

			int depth1 = depth[node1];
			int depth2 = depth[node2];
			int distance = 0;

			if (depth1 < depth2) {
				int tmp = node1;
				node1 = node2;
				node2 = tmp;

				depth1 = depth[node1];
				depth2 = depth[node2];
			}

			distance = calculateLCA(parentNode, depth, distances, node1, node2);
			System.out.println(distance);
		}
	}

	public static int calculateLCA(int parent[], int depth[], int distance[], int node1, int node2) {

		int depth1 = depth[node1];
		int depth2 = depth[node2];
		int ans = 0;

		while (depth1 > depth2) {
			ans += distance[node1];
			node1 = parent[node1];
			depth1 = depth[node1];
		}

		while (node1 != node2) {
			ans += distance[node1];
			ans += distance[node2];
			node1 = parent[node1];
			node2 = parent[node2];
		}

		return ans;
	}

	public static int[] calculateNodeDepth(LinkedList<Node> pair[], int parent[], int distance[], int n) {
		Queue<Node> queue = new LinkedList<Node>();
		int depth[] = new int[n + 1];
		boolean isVisited[] = new boolean[n + 1];

		queue.add(new Node(1, 0));
		depth[1] = 0;
		isVisited[1] = true;

		while (!queue.isEmpty()) {

			Node node = queue.poll();

			for (Node i : pair[node.name]) {
				if (!isVisited[i.name]) {
					queue.add(i);
					depth[i.name] = depth[node.name] + 1;
					parent[i.name] = node.name;
					distance[i.name] = i.distance;
					isVisited[i.name] = true;
				}
			}
		}
		return depth;
	}
}

class Node {
	int name;
	int distance;

	public Node(int name, int distance) {
		this.name = name;
		this.distance = distance;
	}
}
이 문제의 주의할 점은 입력 시 어떤 노드가 parent이고 어떤 노드가 child인지 알 수 없으므로
bfs을 돌 때 parent와 child를 정의할 수 있다.
import java.util.*;

public class Main {
	public static void main(String[] args) {
		Scanner in = new Scanner(System.in);
		int n = in.nextInt();

		int[] depth = new int[n + 1];
		int[] parentNode = new int[n + 1];
		boolean[] isVisited = new boolean[n + 1];
		LinkedList<Integer> pair[] = new LinkedList[n + 1];
		for (int i = 1; i <= n; i++) {
			pair[i] = new LinkedList<Integer>();
		}

		for (int i = 1; i < n; i++) {
			int node1 = in.nextInt();
			int node2 = in.nextInt();
			pair[node1].add(node2);
			pair[node2].add(node1);
		}

		depth = calculateNodeDepth(pair, parentNode, n);

		int test = in.nextInt();
		int ans = 1;
		for (int t = 0; t < test; t++) {

			int node1 = in.nextInt();
			int node2 = in.nextInt();

			int depth1 = depth[node1];
			int depth2 = depth[node2];

			if (depth1 < depth2) {
				ans = calculateLCA(parentNode, depth, node2, node1);
			} else{
            	ans = calculateLCA(parentNode, depth, node1, node2);
            }
			System.out.println(ans);
		}
	}

	public static int calculateLCA(int parent[], int depth[], int node1, int node2) {

		int depth1 = depth[node1];
		int depth2 = depth[node2];
		int ans = 1;

		while (depth1 > depth2) {
			node1 = parent[node1];
			depth1 = depth[node1];
		}

		while (node1 != node2) {
			node1 = parent[node1];
			node2 = parent[node2];
		}

		ans = node1;
		return ans;
	}

	public static int[] calculateNodeDepth(LinkedList<Integer> pair[], int parent[], int n) {
		Queue<Integer> queue = new LinkedList<Integer>();
		int depth[] = new int[n + 1];
		boolean isVisited[] = new boolean[n + 1];

		queue.add(1);
		depth[1] = 0;
		isVisited[1] = true;

		while (!queue.isEmpty()) {

			int node = queue.poll();

			for (int i : pair[node]) {
				if (!isVisited[i]) {
					queue.add(i);
					depth[i] = depth[node] + 1;
					parent[i] = node;
					isVisited[i] = true;
				}
			}
		}
		return depth;
	}
}